산업 파운데이션 모델은 무엇이어야 하는가

English version: What an Industrial Foundation Model Should Be
AI 기술이 발전하면서 여러 분야로의 AI 적용도 빠르게 진행되고 있는데요, 특히 국내에서는 정부를 비롯한 여러 분야에서 산업 파운데이션 모델에 대한 연구개발 투자가 이뤄지고 있습니다. 산업부, 과기부 등 여러 정부 부처도 최근 공개되는 R&D 사업들에서 데이터의 중요성과 함께 산업 파운데이션 AI를 위한 데이터 공유를 강조하고 있구요.
다만 여기서 산업 파운데이션 모델에 대해 조금 더 고민해 볼 필요가 있지 않을까 싶어요. 파운데이션 모델은 무엇으로 정의할 수 있을까요? 그리고 산업 파운데이션 모델은 어떤 기능을 제공해야 그 이름에 걸맞은 역할을 할 수 있을까요?
파운데이션 모델의 정의
파운데이션 모델에 대해서는 여러 정의가 있습니다. 이 용어를 처음 정리한 스탠퍼드 CRFM의 보고서는 파운데이션 모델을 “넓은 데이터로 학습되어(주로 대규모 자기지도 학습으로) 다양한 다운스트림 과제에 적응시킬 수 있는 모델”이라고 규정하고 있습니다.1 정의의 무게중심이 ‘모든 것을 안다’가 아니라 ‘그 위에 무언가를 적응시켜 올릴 수 있다’에 있다는 점이 눈에 띄는데요.
이름 그대로인 셈이죠. 파운데이션 모델은 기반이 되는, 기반을 제공할 수 있는 모델이어야 한다고 생각합니다. 모든 것을 이해하고 모든 문제를 해결하는 전지전능한(God-Almighty) 존재라기보다, 그 위에 무언가를 지을 수 있는 반석이나 머릿돌 같은 역할을 해야 하지 않을까요.
전지(全知)한 모델은 기반이 아니다
이 구분은 파운데이션 모델이 산업에 미치는 영향과도 직접 맞닿아 있습니다. 반도체 산업의 파운데이션 모델을 예로 들어 볼까요? 어느 반도체 기업이 방대한 데이터로 제조 공정 의사결정을 지원하는 훌륭한 모델을 개발했다고 해 보죠. 만일 이 모델이 ‘파운데이션 모델’이라는 이름으로 공개된다면, 반도체 시장의 진입장벽을 허무는 결과로 이어질 수 있습니다.
이때 선발주자는 자신의 노하우가 그대로 담긴 모델을 후발주자에게 넘겨주는, 이른바 floor lifting(바닥을 올려 주는) 효과만 얻게 될 가능성이 클 것 같아요. 이런 모델은 파운데이션 모델이라기보다 전능한(almighty) 혹은 전지한(omniscient) 모델이라고 부르는 편이 더 적절해 보입니다. 기반이라기보다 완성품에 가깝기 때문이죠.
기반은 지식을 담는 그릇이 아니라, 지식을 쌓는 반석
그래서 기반 모델, 즉 파운데이션 모델은 각 도메인의 지식을 모두 담은 모델이라기보다, 각 도메인의 지식을 그 위에 쌓을 수 있도록 하는 역할에 더 충실한 편이 좋다고 생각합니다. 도메인 지식이 산업 파운데이션 모델 위에 쌓이고, 이를 통해 제조 공정, 서비스 관리, 품질 관리 등 여러 도메인 특화 산업 모델로 확산될 수 있어야 비로소 ‘기반’이라는 이름에 어울리는 역할을 한다고 볼 수 있겠죠.
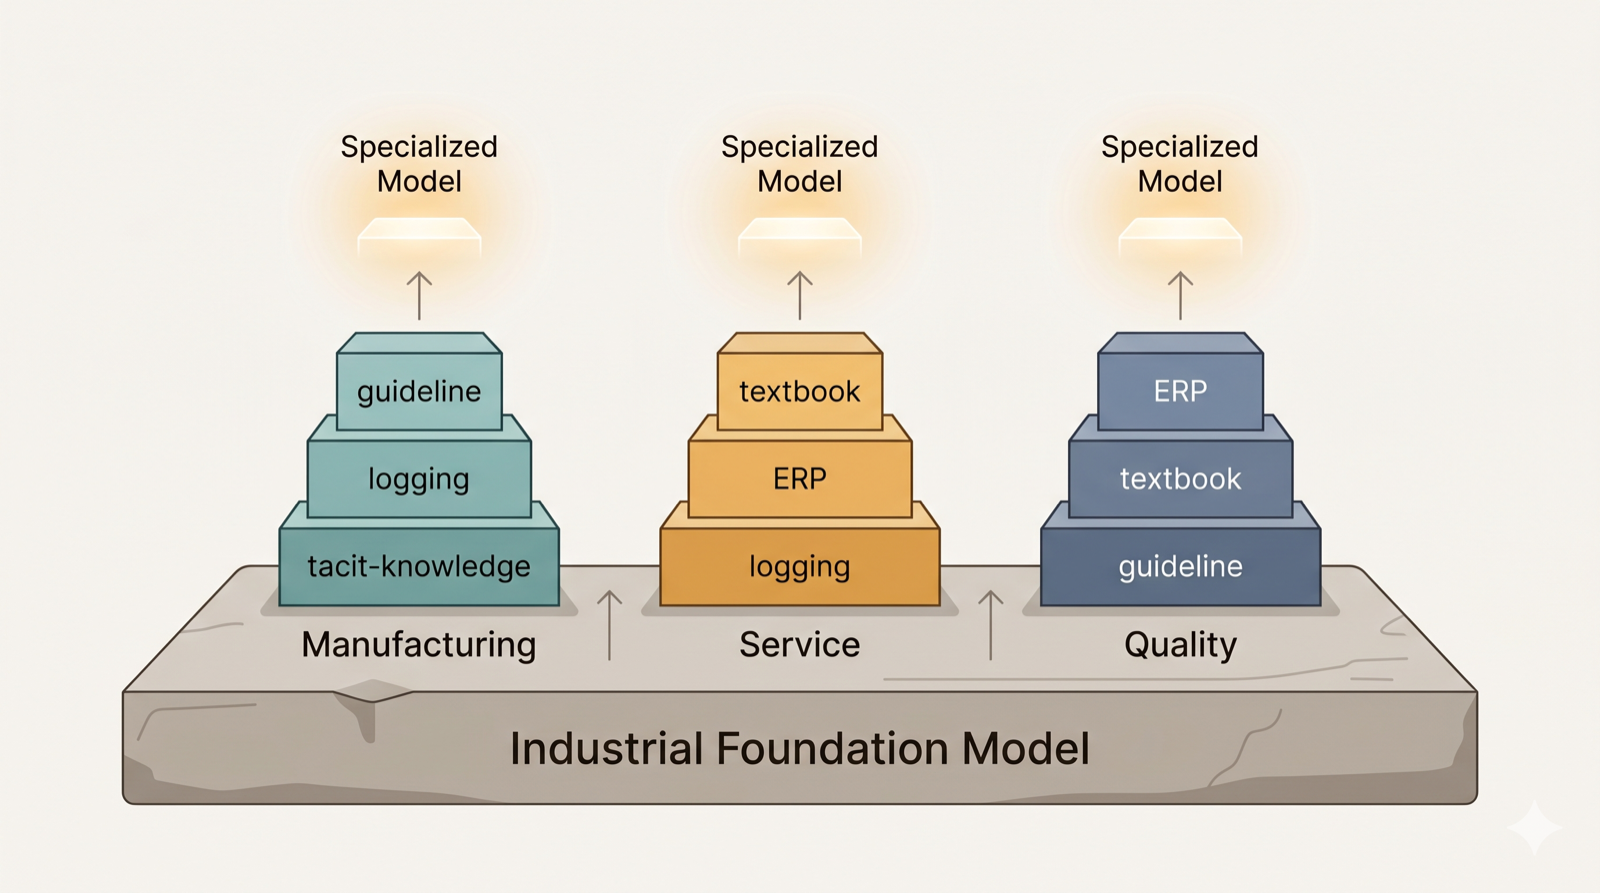
산업 파운데이션 모델 위에 도메인 지식이 쌓여 여러 도메인 특화 모델로 발전하는 구조
앞으로 중요해지는 것
결국 산업 파운데이션 모델을 이야기할 때는 각 도메인의 언어를 이해하고 도메인 지식과의 연계를 지원할 수 있는, 기반이 되는 형태의 서비스 구성이 중요해질 것 같습니다. 모든 답을 미리 담아 둔 모델이 아니라, 도메인의 답이 그 위에서 자라나게 하는 모델 말이에요.
그럼 이런 구조를 실제로 그려 본 사례가 있을까요? 이런 관점을 꽤 구체적으로 보여 주는 사례로 유럽의 IPCEI-AI(Important Projects of Common European Interest 중 AI 분야) 구상을 들 수 있습니다.2 IPCEI-AI는 산업 AI 모델 개발을 하나의 완성된 산출물이 아니라, 세 개의 층위로 쌓여 가는 생애주기(life-cycle)로 그리고 있습니다.
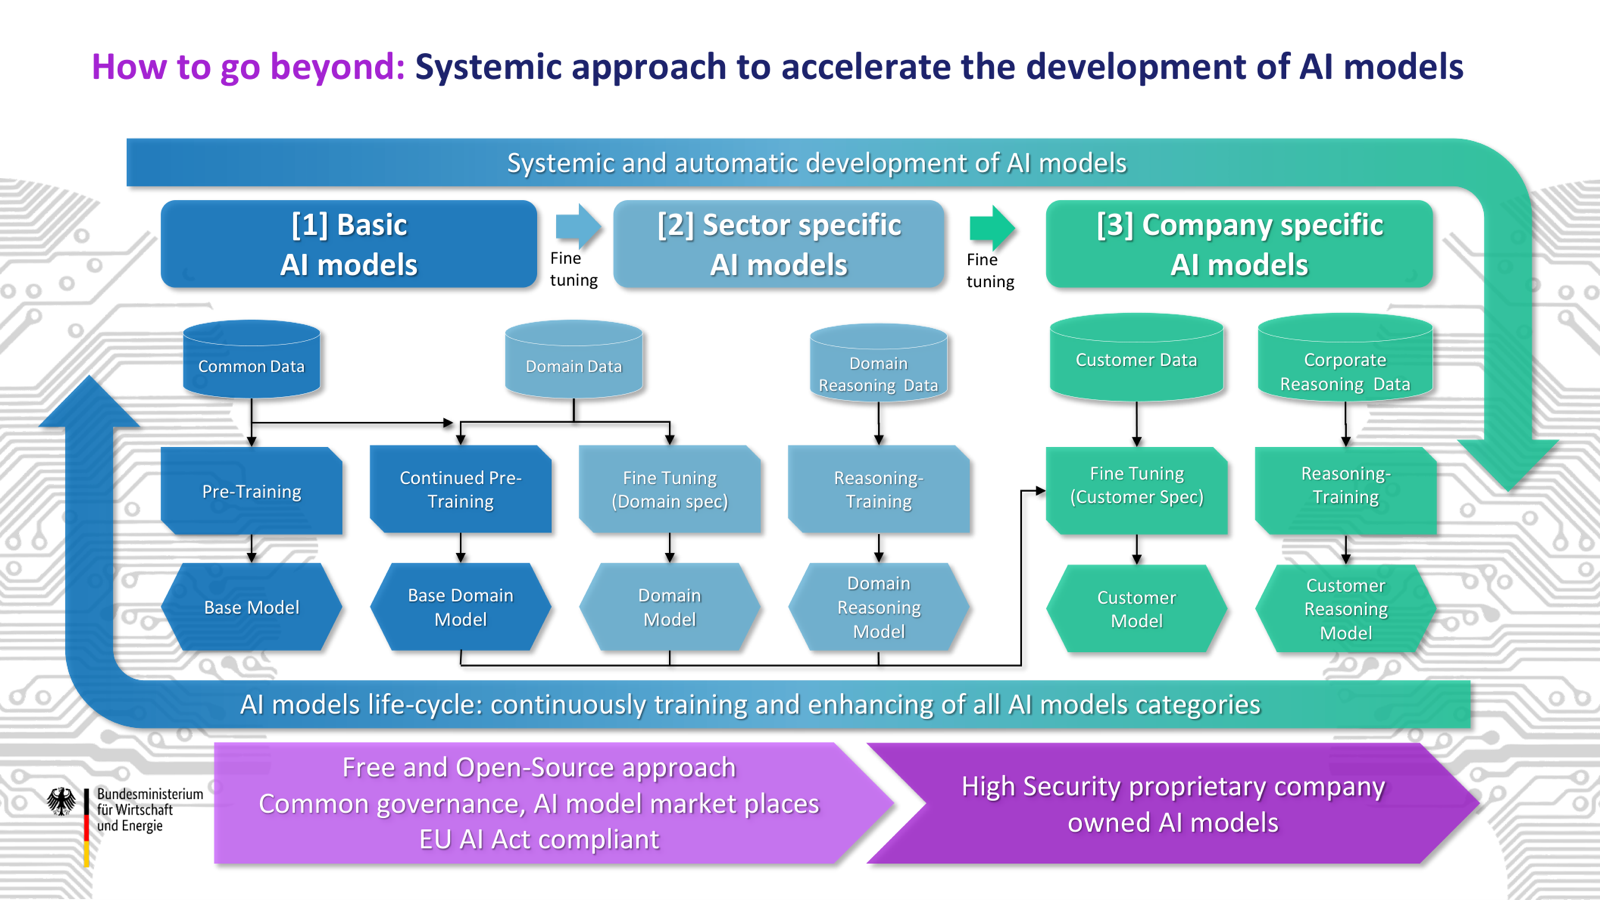
IPCEI-AI가 그리는 산업 AI 모델 개발의 3계층 생애주기: 개방, 공유(free and open-source) 기반 모델에서 위로 갈수록 도메인 및 기업 특화로 좁혀지는 구조 (출처: BMWE, IPCEI-AI)
- 기반 모델(Basic AI models): 공통 데이터로 사전학습(pre-training)된 가장 아래층의 베이스 모델이다. 특징적인 부분은 이 층을 개방과 공유(free and open-source), 공통 거버넌스, AI 모델 마켓플레이스, 그리고 EU AI Act 준수를 갖춘 일종의 공공재로 정의한다는 점이다.
- 섹터/도메인 특화 모델(Sector-specific AI models): 기반 모델 위에서 도메인 데이터로 파인튜닝(fine-tuning)과 추가 사전학습(continued pre-training)을 거쳐 도메인 모델, 나아가 도메인 추론 모델로 발전한다.
- 기업 특화 모델(Company-specific AI models): 다시 그 위에서 고객 및 기업 데이터로 파인튜닝해 만드는, 고보안의 기업 소유 독점 모델이다.
이 그림이 흥미로운 이유는 앞서 이야기한 floor lifting 딜레마에 대한 답을 구조 자체로 제시하기 때문입니다. 기반 모델 층은 누구나 딛고 설 수 있도록 개방하되, 기업의 진짜 노하우는 위쪽의 도메인 및 기업 특화 층에 남기는 거죠. 다시 말해, ‘어디까지를 파운데이션으로 공개할 것인가’의 경계선을 노하우 아래에 긋는 것에 가깝다고 봅니다. 그러면 기반은 모두의 바닥을 올려 주는 공공재 역할을 하면서도, 선발주자가 자기 머릿돌까지 통째로 넘겨주는 일은 피할 수 있습니다.
또 하나 눈여겨볼 점은, 이 세 층이 한 번 만들고 끝나는 정적인 결과물이 아니라 지속적으로 학습되고 강화되는 하나의 생애주기로 묶여 있다는 것입니다. 파인튜닝과 추가 사전학습이 층과 층을 잇는 연결 조직이고, 그 흐름이 끊기지 않게 받쳐 주는 것이 기반 모델의 역할이구요. 결국 산업 파운데이션 모델의 가치는 ‘얼마나 많이 아는가’보다 그 위에서 도메인과 기업의 지식이 얼마나 잘 자라게 하는가에서 나온다고 생각합니다.
-
Bommasani et al., “On the Opportunities and Risks of Foundation Models,” Stanford CRFM, 2021. arXiv:2108.07258 ↩
-
IPCEI-AI (Important Projects of Common European Interest - Artificial Intelligence), 독일 연방경제에너지부(BMWE) 주관. IPCEI Artificial Intelligence (BMWE) ↩