산업 AI의 지속가능성은 결국 'AI 가시성'에서 온다

English version: Industrial AI and its visibility
앞선 글에서 산업 파운데이션 모델은 무엇이어야 하는가 이야기를 꺼냈는데요, 다만 이번에는 조금 더 현실적인 질문을 함께 들여다보고 싶습니다. 미리 조금 말씀드리면, 이 글이 결국 향하는 곳은 AI 가시성(visibility) 입니다. 산업 AI가 한 번 만들고 끝나는 물건이 아니라 계속 살아 있는 시스템이 되려면, 아무래도 이 가시성이 열쇠가 아닐까 싶어요.
AI가 빠르게 발전하고 있다는 건 다들 느끼고 계실 것 같아요. 저도 몇몇 AI 서비스를 즐겨 쓰는데(특히 Claude의 팬입니다), 작년 여름과 가을까지만 해도 “내 일에 조금 도움은 되지만 아직 좀 어설프네” 싶던 도구들이 작년 말과 올해 초를 지나며 부쩍 좋아졌습니다. 이제는 제가 직접 손볼 일을 점점 줄여 주구요. 최근 논문 한 건은 설계만 제가 맡고 구현과 결과 정리는 거의 Claude Code에 맡겼는데, 그 완성도에 솔직히 좀 놀랐습니다.
상용 AI만으로 충분하다는 생각
그러다 보면 자연스럽게 이런 질문이 떠오릅니다. 산업 AI 모델이 따로 필요할까요? 그냥 상용 AI 서비스를 쓰면 안 될까요? 실제로 “Claude나 ChatGPT 쓰면 되지 않냐”고 묻는 분도 많습니다. 성능도 이미 충분히 높으니 그럴 만하죠.
작년만 해도 RAG를 위해 NL2SQL(자연어 → 쿼리) 정확도를 끌어올리는 연구가 제 계획에 있었는데, 지금은 슬그머니 빠졌습니다. 상용 AI에 엑셀 파일과 DB 스키마만 건네주면, 별다른 설명이 없어도 그 안의 맥락을 척척 파악해 꽤 수준 높은 쿼리를 바로 만들어 내거든요. 게다가 그 쿼리를 직접 실행해 보고, 에러 메시지를 읽고, 스스로 고쳐 다시 시도하는 것까지 알아서 해냅니다.
그래도 남는 고민: 정보 보호
그래도 상용 AI 앞에서 다들 한 번쯤 조심스러워하는 지점이 있는데요, 바로 정보 유출입니다. 저도 이번에 사업계획서 몇 건을 준비하며 Claude와 ChatGPT의 도움을 받았는데, 해외 서비스들이 국내 RFP와 사업계획서 양식까지 너무 잘 이해하고 있어서 내심 놀랐습니다. 뒤집어 보면, 질문을 던지는 과정에서 이미 적지 않은 정보를 그쪽에 흘려보내고 있다는 뜻이기도 하겠죠. 요즘 같은 시대에 정보는 곧 자산인데, 그 자산이 상용 AI로 흘러 들어간다는 건, 누군가가 내 자산을 손쉽게 가져다 더 좋은 결과를 낼 수도 있다는 의미이기도 합니다.
그래서 산업 AI의 첫 번째 제약은 아무래도 정보 보호가 될 것 같아요. 분리망이나 내부망에서 운용해 정보가 바깥으로 새어 나가는 길 자체를 막는 구조 말이죠. 이건 기존의 정보보호와는 결이 조금 다릅니다. 예전에는 물리 계층이나 서비스 단에서, 서비스에 대한 일부 정보만으로 암호화나 공격 방어를 고민했다면, 이제는 그 대상이 데이터, 모델, 변조처럼 점점 구체화되고, 그만큼 더 세밀한 보안 및 안전 정책이 필요해질 수 있습니다.
성능, 그리고 비용
닫힌 공간에서 정보를 지킬 수 있게 되었다고 해 볼까요? 그다음 고민은 성능입니다. 흔히 떠올리는 “전통적인” 방법으로는 fine-tuning, tool calling, RAG를 통한 지식 연계 등이 있습니다. 시작된 지 10년, 아니 5년도 안 된 기술을 “전통적”이라 부르는 게 좀 멋쩍긴 하지만요.
여기서 비용 이야기가 빠질 수 없겠죠. 데이터를 모으고, 레이블을 붙이고, 추가 학습을 돌리는 일은 제대로 하려면 생각보다 돈이 꽤 듭니다.
지속가능성
잘 만들어 두었다고 끝이 아니라는 점도 짚고 싶습니다. 그다음은 지속가능성입니다. 수명이 짧은 제조 공정, 끊임없이 바뀌는 입력 데이터, 계속 갱신되는 규정, 법령, 규제. 한 번 잘 만든 모델이 그대로 오래 가 주면 좋겠지만, 현실은 그렇게 너그럽지 않은 것 같아요.
세 가지 고민
여기까지만 보면 “산업 AI 모델, 그냥 안 하는 게 낫겠다” 싶어질 수도 있습니다. ㅎㅎ 그래도 고민의 축을 추려 보면 의외로 간단하게 다음 세 가지로 모아 볼 수 있을 것 같아요.
- 정보 보호: AI를 쓰면서 내 정보를 어떻게 지킬 것인가.
- 정확도와 비용: 정확도를 어떻게 올리고, 그 비용을 어떻게 줄일 것인가.
- 지속가능성: 그리고 가장 중요한, 이 모든 걸 어떻게 계속 굴러가게 할 것인가.
AI는 정말 돈이 많이 듭니다. 파운데이션 모델을 검토해 고르고, 데이터를 구축하고 검수하고, 레이블을 붙이고, 추가 학습을 하고, 보안까지 입혀서 이렇게 공들여 만들어 놨는데, 대상 제품이나 서비스가 바뀌면 또 처음부터 다시 해야 하거든요. 이 반복이 비용의 큰 부분을 차지하고, 그래서 세 번째인 지속가능성이 앞의 두 가지를 모두 아우르는 가장 큰 고민이 아닐까 싶습니다.
파운데이션 모델의 역할
그럼 지속가능성을 위해 파운데이션 모델은 어떤 역할을 맡는 게 좋을까요? 지속가능성을 생각하면, 제가 가장 중요하게 보는 건 컨텍스트 이해와 도메인 정보를 분리하는 일입니다. 이 둘은 가능하면 나누어 두는 편이 좋고, 컨텍스트 이해는 파운데이션 모델이, 도메인 정보와의 연계는 여러 도구를 활용한 에이전트 구성이 맡는 방식이 바람직해 보여요.
데이터를 넣고 “이 데이터 상태 어때?”라고 물었을 때, 학습된 모델이 곧바로 답을 내놓는 방식이 아닙니다. 먼저 질문의 의도(컨텍스트)를 파악하고, 그에 맞는 도구를 호출해, 모델이 학습하지 않은 도메인 지식을 도구로 가져오는 방식에 가깝다고 봅니다.
이때 파운데이션 모델의 역할은 컨텍스트를 이해하고, 그 컨텍스트에 맞는 도구 호출 방법을 제시하는 데까지로 한정해 볼 수 있습니다. 파운데이션 모델이 시계열 데이터를 직접 해석할 필요도, 새로운 분류 기법을 알아야 할 필요도 없구요. 이렇게 역할을 나눠 두면 재학습이나 fine-tuning에 대한 부담이 줄고, 결국 비용도 함께 내려갑니다. 도메인 지식 쪽은 잘 정리해 두고, 데이터가 바뀔 때(수정, 추가, 삭제)마다 closed-loop로 꾸준히 갱신해 주면 되겠죠.
여기까지가 ‘설계’입니다. 그런데 이 설계는 가만히 두면 시간이 지날수록 조금씩 어긋나기 마련이에요. 그 어긋남을 따라잡는 장치에 대한 이야기가 다음에 이어집니다.
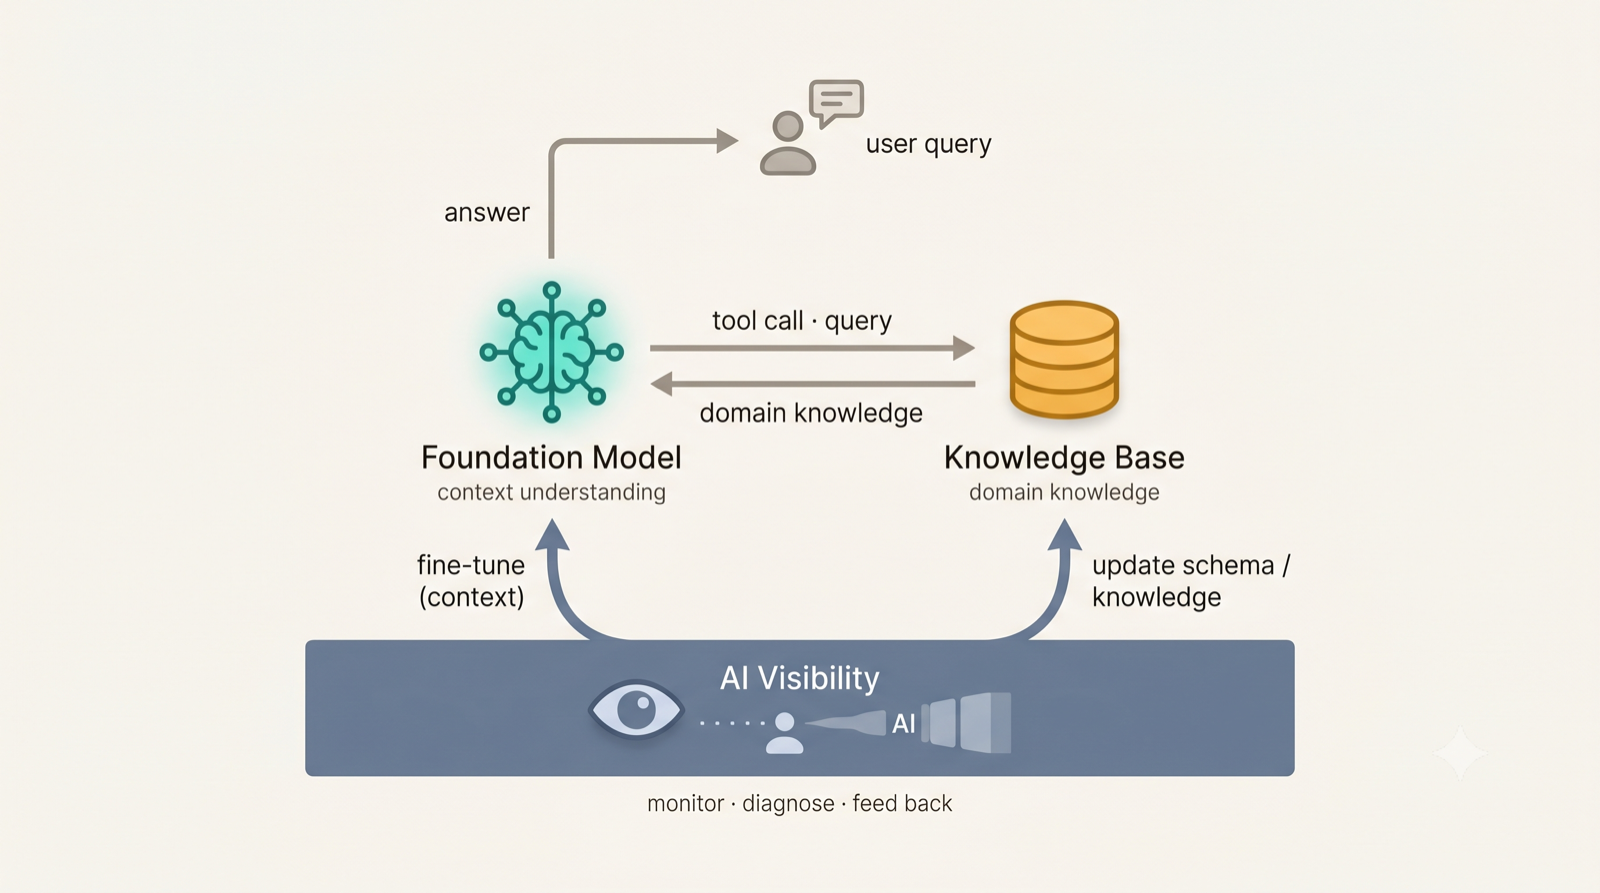
컨텍스트 이해(파운데이션 모델)와 도메인 지식(지식베이스)의 분리, 그리고 사용자-AI 상호작용을 모니터링해 fine-tuning과 스키마/지식 갱신의 두 축으로 feedback하는 AI 가시성
가장 중요한 요소: AI 가시성(visibility)
컨텍스트 이해(파운데이션 모델)와 도메인 지식(지식베이스와 도구)을 아무리 잘 나눠 두어도, 공정이 바뀌고 데이터가 바뀌고 규정이 바뀌면 양쪽 모두 조금씩 어긋나기 시작합니다. 곤란한 건, 어디가 왜 어긋났는지 알지 못하면 손을 대기가 어렵다는 점이죠. AI 가시성은 바로 그 ‘어디서, 왜’를 보이게 해 주는 역할이라고 생각합니다.
조금 더 구체적으로 살펴볼까요? 사용자가 어떤 도메인 지식을 요청했는데 답을 받지 못했다면, 원인은 대개 둘 중 하나로 볼 수 있습니다. AI가 컨텍스트 자체를 이해하지 못했거나, 컨텍스트는 이해했는데 지식베이스에 맞는 쿼리를 만들어 내지 못했거나. 이 둘은 성격이 전혀 다른 실패라, 처방도 달라지는데요. 앞쪽은 파운데이션 모델의 컨텍스트 이해를 높이는 문제(예: fine-tuning)에 가깝고, 뒤쪽은 지식베이스의 구성이나 스키마 문제에 가깝습니다.
그래서 가시성은 단순한 로깅과는 조금 다릅니다. 사용자와 AI의 상호작용을 꾸준히 지켜보면서, ① 사용자에게 닿지 못한 지식이 무엇인지 짚고, ② 그 원인이 컨텍스트 이해 쪽인지 지식베이스 쪽인지 가려내고, ③ 그 진단을 각 축으로 되돌려 주는 feedback loop에 가깝다고 봐요. 컨텍스트 이해가 부족하면 파운데이션 모델 쪽으로(fine-tuning 등), 지식이 비어 있으면 지식베이스 쪽으로(스키마, 지식 추가).
이런 feedback이 있어야 비로소 산업 AI가 ‘한 번 만들고 끝’이 아니라, 바뀌는 현장을 따라 스스로 갱신되는 살아 있는 시스템이 될 수 있습니다. 가시성이 없으면 앞에서 공들인 분리도, closed-loop도, 결국 지속가능성도 말잔치에 그치기 쉽구요. 반대로 가시성이 제대로 작동하면, 정확도 개선이나 비용 절감조차 ‘한 번의 대규모 재학습’이 아니라 ‘진단에 따른 국소적인 갱신’으로 풀 수 있습니다. 그래서 조심스럽지만, 저는 앞의 세 제약을 풀어 가는 데 가시성이 사실상 지렛대 역할을 한다고 생각합니다.
결론
정리하면, 산업 AI 모델은 “상용 모델보다 더 큰 만능 모델”을 만드는 일이 아니라는 생각이 듭니다. 오히려 그 반대에 가깝죠. 정보가 보호되는 닫힌 환경 안에서, 컨텍스트를 이해하는 파운데이션 모델과 도메인 지식을 담은 지식베이스와 도구를 분명히 나누고, 그 사이를 에이전트가 이어 주는 구성까지가 설계의 영역이라고 봅니다.
다만 그 설계를 지속가능하게 만들어 주는 건 결국 AI 가시성이 아닐까 싶어요. 무엇이 왜 사용자에게 닿지 못했는지를 보이게 하고, 그 진단을 컨텍스트 이해와 도메인 지식 양쪽으로 되돌려 주는 feedback loop가 갖춰질 때, 비로소 산업 AI도 바뀌는 현장을 따라 오래 살아남을 수 있을 것 같습니다.
지난 글에서 파운데이션 모델은 “모든 걸 아는 모델”이 아니라 “그 위에 지식을 쌓는 반석”이어야 한다고 했는데요, 한 걸음 더 나아가 보면 그 반석 위의 구조물이 무너지지 않도록 계속 지켜보고 손봐 주는 일이 바로 가시성이고, 이것이 산업 AI를 상용 AI와 다르게 만들어 주는 진짜 가치가 아닐까 합니다.